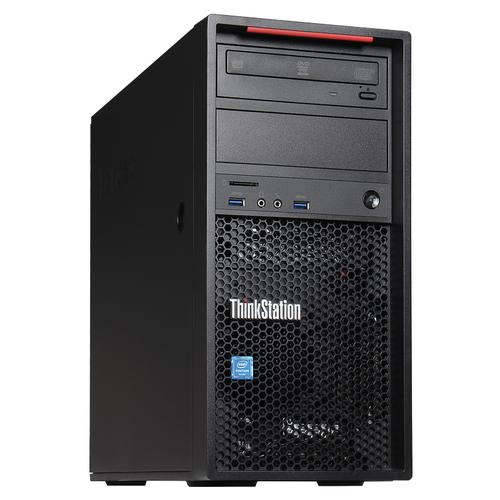
128G内存+单卡RTX 4060 8G塔式工作站 深度学习与DeepSeek部署的性价比之选
引言
在深度学习与大模型应用日益普及的今天,并非所有开发者都需要顶级的A100/H100集群。对于个人研究者、小型团队或初学入门者而言,一台128G内存、单卡RTX 4060 8G的塔式工作站,恰恰是平衡性能与成本的高性价比之选。尤其当你想本地运行或微调如DeepSeek这类高效开源大模型时,这样的配置可以发挥出超乎预期的实用性。
本文将深入分析这套配置的适用场景、性能边界,以及如何用它搭建一台针对深度学习与DeepSeek的专属服务器工作站。
为什么是128G内存 + RTX 4060 8G?
1. 128G内存:大模型推理与数据预处理的基石
在深度学习工作流中,系统内存(RAM)常被低估。实际上:
- 模型加载与卸载:即使使用GPU推理,模型权重首先加载到内存,再传输到显存。128G内存允许你轻松加载7B~14B参数量的模型(全精度或半精度),并为操作系统、数据集缓存留足空间。
- DeepSeek模型本地部署:DeepSeek系列包含多种尺寸,如DeepSeek-Coder-6.7B、DeepSeek-V2-Lite等。128G内存可在不触发磁盘交换的情况下,流畅进行模型转换、量化及多任务并发。
- 数据处理与增强:处理大规模图像、文本数据集时,充足内存可显著减少I/O瓶颈。
2. RTX 4060 8G:入门级深度学习的甜点卡
RTX 4060 8G基于Ada Lovelace架构,拥有3072个CUDA核心,8GB GDDR6显存,并支持FP8精度(通过软件模拟)。其优势包括:
- 低功耗:TDP仅115W,对电源和散热要求低,适合塔式工作站长时间运行。
- DLSS 3与AI加速:虽为游戏卡,但Tensor Core完整,支持混合精度训练与推理。
- 性价比:单卡价格约2000-2500元,远低于专业卡。
8G显存的边界:
- 可直接推理4-bit量化的7B模型(如DeepSeek-R1-Distill-Qwen-7B),显存占用约4-6G。
- 可微调小模型(如BERT-base)或使用LoRA/QLoRA技术微调7B模型。
- 无法全量微调7B以上模型,也无法训练大视觉模型,但适合入门与轻量任务。
塔式工作站的优势
相比机架式服务器或云GPU,塔式工作站具备:
- 静音与低功耗:适合办公室或实验室环境,无需专用机房。
- 扩展灵活:标准ATX主板,可升级内存、增加硬盘、更换GPU。
- 成本可控:整机预算约6000-8000元,即可获得128G内存+RTX 4060配置。
针对DeepSeek的部署实践
推荐软件栈
- 操作系统:Ubuntu 22.04 LTS(深度学习生态最佳)
- 驱动:NVIDIA Driver 535+,CUDA 12.2
- 推理框架:
- llama.cpp:支持CPU+GPU混合推理,充分利用128G内存,可运行DeepSeek量化版。
- Ollama:一键拉取和运行DeepSeek模型,简单易用。
- vLLM:若显存足够,可部署量化版进行高吞吐推理。
- 训练/微调:PyTorch + Hugging Face Transformers + PEFT(LoRA)。
部署示例:DeepSeek-R1-Distill-Qwen-7B
1. 使用Ollama拉取4-bit量化模型:
`bash
ollama run deepseek-r1:7b
`
实际推理时,模型约4.5G显存,剩余约3.5G可用于上下文缓存。128G内存确保加载迅速且多轮对话不卡顿。
- 若需微调,可使用QLoRA在RTX 4060上微调7B模型:
- 显存占用约6-7G,批量大小设为1-2。
- 训练速度较慢,但可行。结合128G内存,数据加载无瓶颈。
性能预期与局限性
能做好的事
- 本地运行7B级别量化模型,进行对话、代码生成、文本摘要。
- 微调小模型或使用LoRA微调7B模型(小数据集)。
- 计算机视觉任务:训练ResNet、MobileNet等轻量模型。
- 作为开发机,连接远程GPU集群。
局限与应对
- 显存瓶颈:8G显存无法全量微调7B模型,也无法运行未量化的13B+模型。应对:使用量化、LoRA、或CPU卸载(llama.cpp)。
- 训练速度:单卡训练大模型极慢,建议仅用于推理或微调。可考虑租用云GPU进行大规模训练。
配置建议与预算
| 组件 | 推荐型号 | 预算(元) |
|------|----------|------------|
| CPU | Intel i5-13400 / AMD Ryzen 5 7600 | 1200-1500 |
| 主板 | B760 / B650 | 800-1000 |
| 内存 | 128GB DDR4/DDR5 (4×32GB) | 2000-2500 |
| GPU | RTX 4060 8G | 2200-2500 |
| 存储 | 1TB NVMe SSD + 2TB HDD | 600-800 |
| 电源 | 550W 金牌 | 400 |
| 机箱 | 塔式静音 | 300 |
| 总计 | | 约7500-8500 |
注:若已有部分配件,成本可进一步降低。
结论
128G内存 + 单卡RTX 4060 8G的塔式工作站并非性能猛兽,但它是深度学习入门与DeepSeek本地部署的绝佳起点。它让你以较低成本获得完整的硬件控制权,能够运行7B级别模型、进行轻量微调,并作为学习深度学习的稳定平台。当任务超出其能力时,亦可无缝过渡到云GPU或升级硬件。对于个人开发者、学生和小型团队,这是一套值得认真考虑的务实配置。
最新产品